Rozkład prawdopodobieństwa
Rozkład prawdopodobieństwa zmiennej losowej mówi nam, jakie jest prawdopodobieństwo, że zmienna losowa przyjmie akurat daną wartość.
Rozkład zmiennej dyskretnej
Weźmy jakąś dyskretną (skokową) zmienną losową, moglibyśmy na przykład obserwować, ile półlitrowych kufli piwa dziennie wypija miejscowy pijaczyna Zenek. Obserwując Zenka przez cały jeden miesiąc, zbudowaliśmy następującą tabelę:
| Dzień | Liczba kufli piwa | Dzień | Liczba kufli piwa | Dzień | Liczba kufli piwa |
|---|---|---|---|---|---|
| 1. | 5 | 11. | 10 | 21. | 4 |
| 2. | 10 | 12. | 5 | 22. | 6 |
| 3. | 4 | 13. | 12 | 23. | 10 |
| 4. | 4 | 14. | 10 | 24. | 10 |
| 5. | 5 | 15. | 12 | 25. | 4 |
| 6. | 4 | 16. | 12 | 26. | 5 |
| 7. | 0 | 17. | 6 | 27. | 10 |
| 8. | 5 | 18. | 10 | 28. | 5 |
| 9. | 4 | 19. | 6 | 29. | 0 |
| 10. | 5 | 20. | 10 | 30. | 10 |
Widzimy, że na początku miesiąca Zenek jeszcze trochę się oszczędzał, ale potem wlewał w siebie jedno piwo za drugim. A tydzień od 11. dnia musiał być szalony. Oznaczmy tę dyskretną zmienną losową X. Teraz będzie nas interesować, jakie jest prawdopodobieństwo tego, że Zenek w jakimś jednym dniu miesiąca wypije dokładnie x kufli piwa.
Zanim obliczymy samo prawdopodobieństwo, zbudujemy zwykły wykres liczebności. Znajdziemy wszystkie liczby kufli piwa, które Zenek wypił w poszczególne dni, i naniesiemy je na wykres liczebności. Na przykład dziesięć kufli Zenek wypił w sumie dziewięć razy, więc dla wartości dziesięć kufli będziemy mieć słupek o wysokości dziewięć:
Wykres czytamy tak, że sześć kufli Zenek wypił przez trzy dni w miesiącu.
Jakie jest prawdopodobieństwo, że Zenek wypił w ciągu dnia dziesięć kufli? Formalnie zapisalibyśmy to tak: funkcję prawdopodobieństwa oznaczymy P, a pytanie o dziesięć kufli zapisalibyśmy tak: P(X = 10). Pytamy w ten sposób, jakie jest prawdopodobieństwo, że zmienna losowa X przyjmuje wartość dziesięć.
Prawdopodobieństwo będzie równe częstości danej wartości. Zbudujemy więc jeszcze wykres częstości:
Teraz możemy powiedzieć, że P(X = 10) jest równe 0,3, czyli 30%.
Prawdopodobieństwo statystyczne a matematyczne
Weźmy jako przykład zwykłą kostkę do gry. Rzućmy nią 600 razy. Z punktu widzenia klasycznego prawdopodobieństwa matematycznego mamy tak samo dużą szansę, że wypadnie nam jedynka, dwójka, …, szóstka. Każda ściana kostki wypada z prawdopodobieństwem $\frac16$. Czysto teoretycznie każda ściana powinna więc wypaść dokładnie sto razy, skoro rzucaliśmy kostką sześćset razy.
To się oczywiście najpewniej nie stanie. W naszym doświadczeniu możemy otrzymać takie wyniki:
| Liczba oczek | Liczba rzutów | Częstość |
|---|---|---|
| 1 | 105 | 0,175 |
| 2 | 103 | 0,171666 |
| 3 | 90 | 0,15 |
| 4 | 96 | 0,16 |
| 5 | 100 | 0,16666 |
| 6 | 106 | 0,17666 |
Widzimy, że częstość, a więc i prawdopodobieństwo, wypadnięcia jednego oczka wynosi 0,175, czyli 17,5%. To wprawdzie blisko prawdopodobieństwa $\frac16$, czyli 0,16666…, ale nie jest to całkiem dokładne.
Nie znaczy to, że jedno albo drugie prawdopodobieństwo jest złe. Zbudowanie idealnie wyważonej kostki wcale nie jest łatwym zadaniem, tak samo trudne może być przeprowadzenie samego testu, w którym rzucamy kostką 600 razy.
Prawdopodobieństwo matematyczne działa więc w warunkach idealnych, w których rzucalibyśmy kostką w nieskończoność. Im dłużej rzucalibyśmy idealnie wyważoną kostką, tym bardziej częstości poszczególnych wyników zbliżałyby się do teoretycznego prawdopodobieństwa matematycznego.
Dlatego rozróżniamy dwa prawdopodobieństwa — matematyczne, które wynika z wyidealizowanych warunków, i statystyczne (inaczej empiryczne), które obliczamy z częstości w naszych danych.
Żeby obliczyć prawdopodobieństwo statystyczne, powinniśmy mieć do dyspozycji odpowiednio duży zbiór danych. Na przykład naszego pijaczynę Zenka obserwowaliśmy tylko przez miesiąc, a dużo lepiej byłoby, gdybyśmy obserwowali go co najmniej rok.
Rozkład zmiennej ciągłej
Przy zmiennej ciągłej nie wyznaczamy prawdopodobieństwa w konkretnym punkcie, ale zawsze tylko w przedziale. Prawdopodobieństwo będzie równe polu pod krzywą, więc do obliczeń będziemy potrzebować całki. Możemy mieć taki wykres zmiennej ciągłej, może to być na przykład pomiar jakiegoś odchylenia w cm:
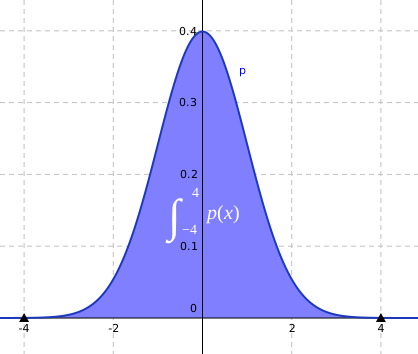
Na osi x mamy więc wartości w cm, na osi y częstości. Załóżmy, że zmierzyliśmy tylko wartości w przedziale <−4, 4>. Prawdopodobieństwo empiryczne, że zmierzymy odchylenie w tym przedziale, wynosi więc 1, czyli 100%.
Jak ma się do tego pole? Powiemy, że pole $\int_{-4}^4 p(x)$, gdzie p jest funkcją gęstości prawdopodobieństwa, odpowiada właśnie tym 100%. Gdybyśmy zapytali, jakie jest prawdopodobieństwo empiryczne, że wartość będzie w przedziale <0, 4>, dostalibyśmy taki obrazek:
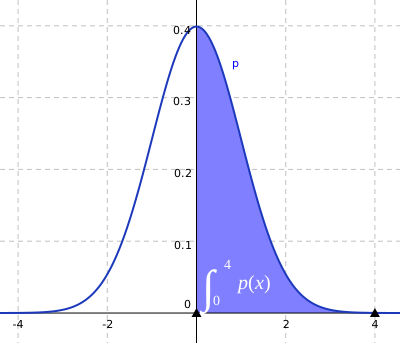
Poprzednia zaznaczona część odpowiadała 100%, ta odpowiada 50%, bo jej pole jest wyraźnie o połowę mniejsze. Dokładnie wyrazilibyśmy prawdopodobieństwo statystyczne jako stosunek
$$ \frac{\int_{0}^4 p(x)}{\int_{-4}^4 p(x)}. $$
Prawo wielkich liczb
Z poprzednim rozdziałem wiąże się znane prawo wielkich liczb. Mówi ono nieformalnie, że przy dużej liczbie niezależnych prób częstość (prawdopodobieństwo statystyczne) będzie się zbliżać do prawdopodobieństwa matematycznego.
Możemy to sobie znów wyobrazić na rzucie monetą. Może nam wypaść orzeł albo reszka, każda strona ma prawdopodobieństwo $\frac12$, czyli 50%. Jeśli rzucimy monetą cztery razy, może nam wypaść trzy razy reszka i raz orzeł. Częstości wynoszą więc $\frac34$ i $\frac14$. To dość daleko od $\frac12$.
Jeśli rzucimy w sumie dziesięć razy, może nam wypaść siedem razy reszka i trzy razy orzeł. To częstości $\frac{7}{10}$ i $\frac{3}{10}$. Wciąż jest im daleko do $\frac12$, ale te liczby są już bliżej jednej drugiej niż poprzednie częstości.
Tak moglibyśmy ciągnąć dalej. Gdybyśmy rzucili monetą tysiąc razy, mogłaby nam wypaść 520 razy reszka i 480 razy orzeł. To już częstości $\frac{13}{25}$ i $\frac{12}{25}$, które są już bardzo blisko jednej drugiej (dla porównania $\frac{13}{25} = 0,52$).
Zauważ, że chociaż częstości są dużo bliżej jednej drugiej, to liczebności są od „idealnej” liczebności dużo dalej. Kiedy rzuciliśmy monetą dziesięć razy, idealna liczebność każdej strony wynosiła 5. Czyli że pięć razy wypadnie reszka i pięć razy orzeł. Ponieważ reszka wypadła siedem razy, daje to różnicę dwóch rzutów: 7 − 5 = 2. Rzuciliśmy „o dwa rzuty inaczej”, niż byłoby w idealnej sytuacji.
Kiedy jednak rzuciliśmy monetą tysiąc razy, reszka wypadła 520 razy, co daje różnicę 20 rzutów od ideału, bo w idealnym przypadku każda strona powinna wypaść 500 razy. Wydawałoby się więc, że im więcej razy rzucimy, tym dalsze od ideału wyniki dostaniemy.
To jednak wcale nie przeszkadza, prawo wielkich liczb nie twierdzi, że do ideału będą się zbliżać liczebności, ale częstości. A one się zbliżają. Liczebności będą się więc może oddalać, ale częstości będą się przybliżać.