Дисперсія
Дисперсія показує, наскільки сильно розсіяні значення в нашій статистичній сукупності.
Що таке дисперсія
Подивися на таку таблицю, у якій наведено підсумкові оцінки в табелі десяти вибраних учнів 8-Б класу. Нас цікавитимуть два предмети: математика та історія. (У Чехії 1 — найкраща оцінка.)
| Ім'я | Математика | Історія |
|---|---|---|
| Тарас | 2 | 4 |
| Максим | 1 | 1 |
| Юрій | 2 | 1 |
| Мирослав | 2 | 1 |
| Яна | 2 | 3 |
| Олена | 1 | 4 |
| Андрій | 2 | 5 |
| Остап | 2 | 1 |
| Соломія | 2 | 2 |
| Іван | 3 | 4 |
Бачимо, що більшість учнів має з математики двійку, іноді хтось має одиницю або трійку. А в стовпчику з історії маємо цілковитий хаос: оцінки розкидані від одиниці до п'ятірки, і жодна оцінка помітно не переважає. Отже, оцінки з історії розсіяні більше, ніж оцінки з математики.
Якщо обчислити середню оцінку з математики, вийде 1,9. Бачимо, що більшість значень лежить досить близько до цієї величини. А в історії середнє дорівнює 2,6, і більшість оцінок поблизу цього значення не лежить.
Як виразити цей розкид числом?
Як обчислити дисперсію
Перенесемо дані з попередньої таблиці на графік і покажемо лише оцінки з історії.
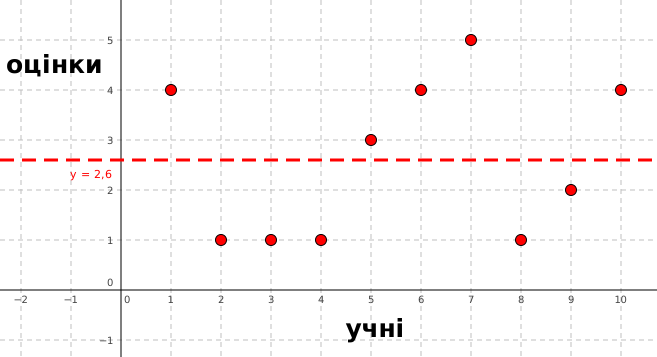
На осі Ox маємо знову учнів (цього разу без імен, тож вважатимемо, що 1 = Тарас, 2 = Максим тощо). На осі Oy маємо підсумкові оцінки. Пряма y = 2{,}6 відповідає середньому значенню.
Дисперсію обчислюємо як середнє значення квадратів відстаней від середнього. Звучить таємниче, але це просто. Квадрат числа x можна уявити як площу квадрата зі стороною завдовжки x. Побудуємо на графіку квадрати, довжина сторони яких дорівнює відстані значення від середнього:
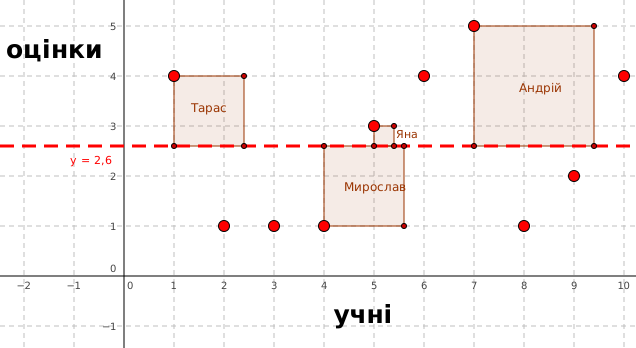
На графіку показано чотири такі квадрати, усі б там не вмістилися. Бачимо, що Яна досить близько до середнього, тому її квадрат малий. А Андрій далеко від середнього, тому квадрат великий. Якби ми побудували всі квадрати й обчислили середню площу цих квадратів, то отримали б дисперсію.
Якщо маємо набір значень X = {x1, x2, …, xN}, де $\overline{x}$ — середнє значення, то дисперсію, позначимо її D, обчислюємо так:
$$ D(X) = \frac1N \left((x_1-\overline{x})^2 + (x_2-\overline{x})^2 + … + (x_N-\overline{x})^2 \right) $$
Або за допомогою суми так:
$$ D(X) = \frac1N\sum_{i=1}^N (x_i-\overline{x})^2 $$
Чому саме $(x_1-\overline{x})^2$? Сам вираз $x_1-\overline{x}$ дав би нам відстань точки x1 від середнього. Точніше, треба було б писати $|x_1-\overline{x}|$ (модуль), якби значення x1 було меншим за середнє. Оскільки ми хочемо знати площу квадрата, підносимо це значення до другого степеня.
Дисперсія нашого набору даних була б така:
$$ \begin{align*} D(\text{Історія}) = \frac{1}{10}((4-2{,}6)^2+(1-2{,}6)^2+(1-2{,}6)^2+\\(1-2{,}6)^2+(3-2{,}6)^2+(4-2{,}6)^2+\\(5-2{,}6)^2+(1-2{,}6)^2+(2-2{,}6)^2+\\(4-2{,}6)^2)=\frac{1}{10}\cdot 22{,}4 = 2{,}24 \end{align*} $$
Дисперсія дорівнює 2,24. Дисперсія оцінок з математики виглядала б так:
$$ \begin{align*} D(\text{Математика}) = \frac{1}{10}((2-1{,}9)^2+(1-1{,}9)^2+(2-1{,}9)^2+\\(2-1{,}9)^2+(2-1{,}9)^2+(1-1{,}9)^2+\\(2-1{,}9)^2+(2-1{,}9)^2+(2-1{,}9)^2+\\(3-1{,}9)^2)=\frac{1}{10}\cdot2{,}9 = 0{,}29 \end{align*} $$
Дисперсія дорівнює 0,29. Бачимо, що в цьому наборі дисперсія, як і очікувалося, набагато менша.
Як обчислити дисперсію в Excel
В Excel для цього є функція VAR.P або якийсь із її варіантів. Наприклад, у VAR.P як аргумент указуємо діапазон клітинок.
Посилання та джерела
- Martina Litschmannová: Úvod do statistiky (чеською)
- Статистика без попередніх знань (чеською)