
Varians
Variansen fortæller os, hvor meget værdierne i vores observationssæt spreder sig. Varians kaldes på engelsk også variance.
Hvad er varians
Se på følgende tabel, som viser slutkaraktererne på karakterbladet for ti udvalgte elever i 8.b. Vi interesserer os for to fag, matematik og historie.
| Navn | Matematik | Historie |
|---|---|---|
| Thomas | 10 | 4 |
| Martin | 12 | 12 |
| Jonas | 10 | 12 |
| Mikkel | 10 | 12 |
| Julie | 10 | 7 |
| Line | 12 | 4 |
| Oscar | 10 | 02 |
| Lucas | 10 | 12 |
| Pernille | 10 | 10 |
| Jan | 7 | 4 |
Vi kan se, at de fleste elever har 10 i matematik, af og til har nogen 12 eller 7. I kolonnen med historie har vi derimod komplet kaos — karaktererne er spredt fra 02 til 12, og ingen karakter dominerer nævneværdigt. Karaktererne i historie er altså mere spredt end karaktererne i matematik.
Når vi beregner gennemsnitskarakteren i matematik, får vi 10,1. Vi kan se, at de fleste værdier ligger forholdsvis tæt på denne værdi. I historie får vi derimod gennemsnittet 7,9, og de fleste karakterer ligger ikke tæt på denne værdi.
Hvordan ville vi udtrykke denne spredning i tal?
Sådan beregner du varians
Dataene fra den foregående tabel overfører vi til en graf og viser kun karaktererne i historie.
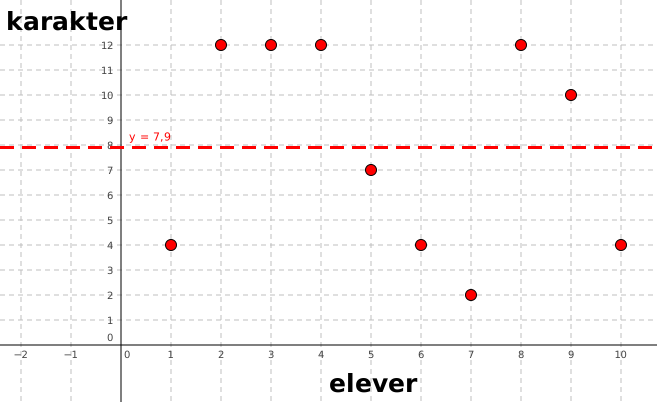
På x-aksen har vi igen eleverne (denne gang uden navne, så lad os antage, at 1 = Thomas, 2 = Martin osv.). På y-aksen har vi slutkaraktererne. Linjen y = 7,9 viser gennemsnittet.
Variansen beregner vi så som gennemsnittet af kvadraterne på afstandene fra gennemsnittet. Det lyder mystisk, men det er enkelt. Kvadratet på x kan vi forestille os som arealet af et kvadrat med sidelængden x. I vores graf tegner vi derfor kvadrater, hvis sidelængde er lig med værdiens afstand fra gennemsnittet:
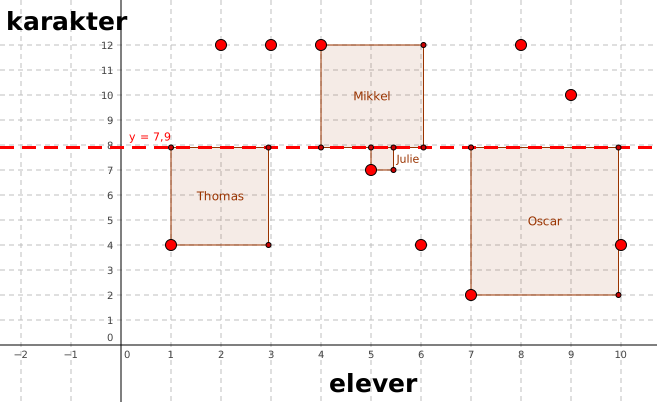
I grafen er der vist fire sådanne kvadrater, de ville ikke alle kunne være der. Vi kan se, at Julie ligger ret tæt på gennemsnittet, og derfor er hendes kvadrat lille. Oscar ligger derimod langt fra gennemsnittet, og derfor er hans kvadrat stort. Hvis vi tegnede alle kvadraterne og beregnede det gennemsnitlige areal af dem, ville vi få variansen.
Hvis vi har et sæt værdier X = (x1, …, xN), hvor
Eller ved hjælp af en sum sådan her:
Hvorfor lige
Variansen af vores datasæt ville således være:
Variansen er 15,29. Variansen af værdierne med resultaterne i matematik ville se sådan ud:
Variansen er 1,69. Vi kan se, at variansen i dette datasæt som forventet er meget mindre.
Sådan beregner du varians i Excel
I dansk Excel bruger du til det funktionen VARIANS.P (på engelsk VAR.P), eller en af de andre varianter af den. Som parameter indsætter vi det valgte celleområde.
