
Sandsynlighedsfordeling
Sandsynlighedsfordelingen for en stokastisk variabel fortæller os, hvor stor sandsynligheden er for, at den stokastiske variabel antager netop en given værdi.
Fordeling af en diskret variabel
Lad os se på en diskret stokastisk variabel. Vi kunne for eksempel følge med i, hvor mange store fadøl (halve liter) den lokale værtshusgænger Bamse drikker om dagen. Ved at følge Bamse i en hel måned har vi lavet følgende tabel:
| Dag | Store fadøl | Dag | Store fadøl | Dag | Store fadøl |
|---|---|---|---|---|---|
| 1. | 5 | 11. | 10 | 21. | 4 |
| 2. | 10 | 12. | 5 | 22. | 6 |
| 3. | 4 | 13. | 12 | 23. | 10 |
| 4. | 4 | 14. | 10 | 24. | 10 |
| 5. | 5 | 15. | 12 | 25. | 4 |
| 6. | 4 | 16. | 12 | 26. | 5 |
| 7. | 0 | 17. | 6 | 27. | 10 |
| 8. | 5 | 18. | 10 | 28. | 5 |
| 9. | 4 | 19. | 6 | 29. | 0 |
| 10. | 5 | 20. | 10 | 30. | 10 |
Vi kan se, at Bamse i begyndelsen af måneden holdt sig lidt tilbage, men så hældte han den ene øl ned efter den anden. Og ugen fra den 11. dag må have været vild. Lad os betegne denne diskrete stokastiske variabel X. Nu vil vi gerne vide, hvor stor sandsynligheden er for, at Bamse på en enkelt dag i måneden drikker netop x store fadøl.
Før vi beregner selve sandsynligheden, laver vi et almindeligt søjlediagram over hyppighederne. Vi finder alle de antal store fadøl, som Bamse drak på en eller anden dag, og afsætter dem i et søjlediagram. For eksempel drak Bamse ti store fadøl i alt ni dage, så for værdien ti store fadøl får vi en søjle med værdien ni:
Diagrammet læser vi sådan, at Bamse drak seks store fadøl tre dage i måneden.
Hvor stor er sandsynligheden for, at Bamse på en dag drak ti store fadøl? Formelt ville vi skrive det sådan her: sandsynlighedsfunktionen betegner vi P, og spørgsmålet om ti store fadøl ville vi skrive sådan her: P(X = 10). Dermed spørger vi, hvor stor sandsynligheden er for, at den stokastiske variabel X antager værdien ti?
Sandsynligheden bliver lig med frekvensen af den pågældende værdi. Så vi laver også et diagram over frekvenserne:
Nu kan vi sige, at P(X = 10) er lig med 0,3, altså 30 %.
Statistisk vs. teoretisk sandsynlighed
Lad os som eksempel tage en almindelig terning. Lad os prøve at slå med den 600 gange. Ud fra den klassiske teoretiske sandsynlighed har vi lige stor chance for at få en etter, en toer, …, en sekser. Hver side af terningen har sandsynligheden
Det sker selvfølgelig sandsynligvis ikke. I vores eksperiment kan vi få disse resultater:
| Tal på terningen | Antal slag | Frekvens |
|---|---|---|
| 1 | 105 | 0,175 |
| 2 | 103 | 0,171666 |
| 3 | 90 | 0,15 |
| 4 | 96 | 0,16 |
| 5 | 100 | 0,16666 |
| 6 | 106 | 0,17666 |
Vi kan se, at frekvensen, og dermed også sandsynligheden, for at få ét øje på terningen er 0,175, hvilket er 17,5 %. Det er ganske vist tæt på sandsynligheden
Det betyder ikke, at den ene eller den anden sandsynlighed er forkert. Det er slet ikke nemt at bygge en helt perfekt afbalanceret terning, og det kan også være svært at gennemføre selve testen, hvor vi slår med terningen 600 gange.
Den teoretiske sandsynlighed fungerer således under ideelle forhold, hvor vi ville slå med terningen i det uendelige. Jo længere tid vi ville slå med en ideelt afbalanceret terning, jo mere ville frekvenserne for de enkelte slag nærme sig den teoretiske sandsynlighed.
Derfor skelner vi mellem to sandsynligheder — den teoretiske, som bygger på idealiserede forhold, og den statistiske (også kaldet empiriske), som vi beregner ud fra frekvenserne i vores data.
For at kunne beregne den statistiske sandsynlighed bør vi have et tilstrækkeligt stort datasæt til rådighed. For eksempel fulgte vi vores værtshusgænger Bamse kun i én måned, men det ville være meget bedre, hvis vi havde fulgt ham i mindst et år.
Fordeling af en kontinuert variabel
For en kontinuert variabel bestemmer vi ikke sandsynligheden i et bestemt punkt, men altid kun i et interval. Sandsynligheden bliver lig med størrelsen af arealet under kurven, så til beregningen får vi brug for et integral. Vi kan have sådan en graf for en kontinuert variabel, det kan for eksempel dreje sig om måling af en afvigelse i cm:
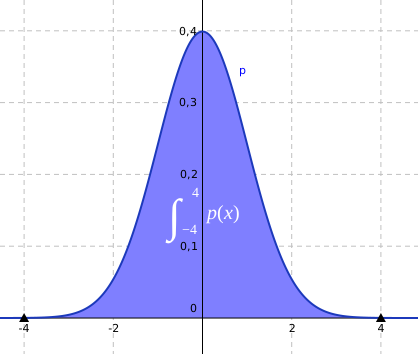
På x-aksen har vi altså værdier i cm, på y-aksen har vi frekvenser. Lad os sige, at vi kun har målt værdier i intervallet [−4; 4]. Den empiriske sandsynlighed for, at vi måler en afvigelse i dette interval, er således 1, altså 100 %.
Hvordan hænger det sammen med arealet? Vi siger, at størrelsen af arealet
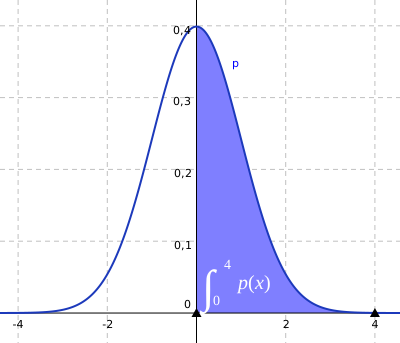
Den foregående fremhævede del svarede til 100 %, denne svarer til 50 %, fordi arealet åbenbart er det halve. Præcist ville vi udtrykke den statistiske sandsynlighed som forholdet
De store tals lov
Med det foregående afsnit hænger den kendte store tals lov sammen. Uformelt siger den, at ved et stort antal uafhængige forsøg vil frekvensen (den statistiske sandsynlighed) nærme sig den teoretiske sandsynlighed.
Vi kan igen forestille os det med et møntkast. Vi kan få plat eller krone, hver side har sandsynligheden
Hvis vi kaster i alt ti gange, kan vi få plat syv gange og krone tre gange. Det er frekvenserne
Sådan kunne vi fortsætte. Hvis vi kastede en mønt tusind gange, kunne vi få plat 520 gange og krone 480 gange. Det er frekvenserne
Læg mærke til, at selv om frekvenserne er meget tættere på en halv, er de absolutte hyppigheder meget længere fra den »ideelle« hyppighed. Da vi kastede en mønt ti gange, var den ideelle absolutte hyppighed for hver side 5. Altså at vi fik plat fem gange og krone fem gange. Fordi vi fik plat syv gange, giver det en forskel på to kast: 7 − 5 = 2. Vi kastede »to kast anderledes«, end der ville ske i den ideelle situation.
Men da vi kastede en mønt tusind gange, fik vi plat 520 gange, hvilket giver en forskel på 20 kast fra idealet, fordi hver side i det ideelle tilfælde skulle være kommet op 500 gange. Det ser således ud til, at jo flere gange vi kaster, jo længere væk fra idealet kommer resultaterne.
Det gør dog ikke noget, de store tals lov påstår ikke, at vi nærmer os idealet for de absolutte hyppigheder, men for de relative. Og dem nærmer vi os. Altså i de absolutte hyppigheder vil vi måske fjerne os, men i de relative vil vi nærme os.
