
Varians
Variansen anger hur mycket värdena i vårt statistiska material är spridda.
Vad är varians
Titta på följande tabell, som visar terminsbetygen för tio utvalda elever i klass 8B. Vi är intresserade av två ämnen, matematik och historia. För att kunna räkna med betygen använder vi betygspoäng: A = 20, B = 17,5, C = 15, D = 12,5 och E = 10.
| Namn | Matematik | Historia |
|---|---|---|
| Hugo | B | D |
| Oscar | A | A |
| William | B | A |
| Lucas | B | A |
| Elsa | B | C |
| Alice | A | D |
| Maja | B | E |
| Noah | B | A |
| Emma | B | B |
| Liam | C | D |
Vi ser att de flesta eleverna har B i matematik, ibland har någon A eller C. I kolumnen med historia är det däremot rent kaos — betygen är spridda från A till E och inget betyg dominerar tydligt. Betygen i historia är alltså mer spridda än betygen i matematik.
Om vi räknar ut medelvärdet av betygspoängen i matematik får vi 17,75. Vi ser att de flesta värdena ligger ganska nära det. I historia får vi i stället medelvärdet 16, och de flesta betygen ligger inte i närheten av det värdet.
Hur kan vi uttrycka den här spridningen med ett tal?
Så beräknar du varians
Data från tabellen ovan för vi över till ett diagram och visar bara betygen i historia.
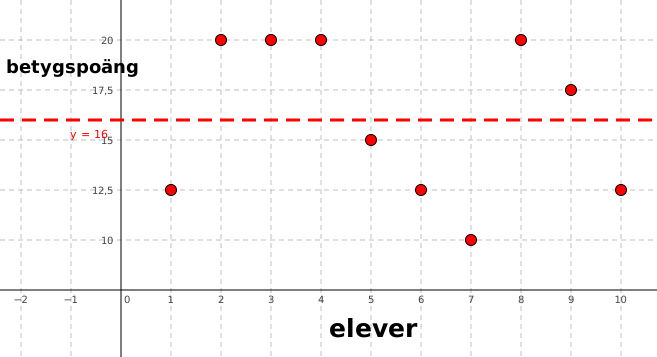
På x-axeln har vi återigen eleverna (den här gången utan namn, så låt oss anta att 1 = Hugo, 2 = Oscar osv.). På y-axeln har vi betygspoängen. Linjen y = 16 visar medelvärdet.
Variansen beräknar vi sedan som medelvärdet av kvadraterna på avstånden från medelvärdet. Det låter mystiskt, men det är enkelt. Kvadraten på x kan vi föreställa oss som arean av en kvadrat med sidlängden x. I vårt diagram ritar vi då kvadrater vars sidlängd är lika med värdets avstånd från medelvärdet:
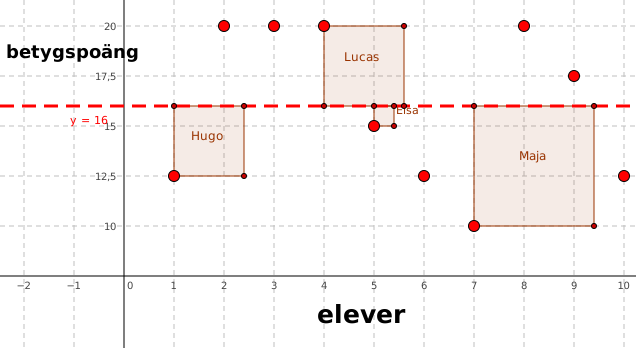
I diagrammet är fyra sådana kvadrater utritade, alla skulle inte få plats. Vi ser att Elsa ligger ganska nära medelvärdet, därför är hennes kvadrat liten. Maja däremot ligger långt från medelvärdet, därför är kvadraten stor. Om vi ritade alla kvadrater och räknade ut medelvärdet av deras areor skulle vi få variansen.
Om vi har en mängd värden X = [x1, …, xN], där
Eller med hjälp av en summa så här:
Varför just
Variansen för vårt datamaterial blir alltså:
Variansen är 14. Variansen för värdena med resultaten i matematik skulle se ut så här:
Variansen är 1,8125. Vi ser att variansen för det här materialet, som väntat, är mycket mindre.
Så beräknar du varians i Excel
I Excel finns funktionen VARIANS.P (på engelska VAR.P) och några varianter av den. Till exempel anger vi i VARIANS.P ett markerat cellområde som argument.
