
Ligefordeling og normalfordeling af hyppighed
Der findes to typiske hyppighedsfordelinger, som vi også i praksis ofte møder. Det er ligefordelingen og normalfordelingen.
Ligefordeling af hyppighed
Ligefordeling betyder, at alle værdier i vores datasæt forekommer lige hyppigt. Vi kan for eksempel tælle, hvor mange måneder årene 2000, 2001, …, 2009 havde:
Hvis vi slår med en klassisk idealiseret terning, har vi sandsynligheden
En ujævn fordeling ville vi have, hvis vi havde en snydeterning, hvor sekseren altid ville have sandsynligheden
Normalfordeling af sandsynlighed
Normalfordelingen kaldes nogle gange også Gauss-fordelingen. Den bruges kun til kontinuerte stokastiske variable. Den standardiserede normalfordeling har denne form:
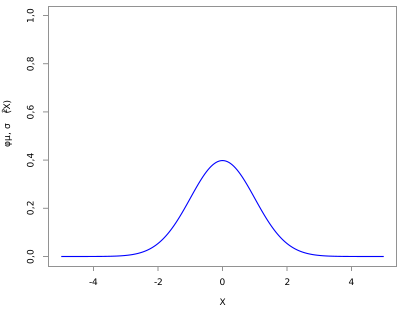
Denne kurve er beskrevet af den såkaldte Gauss-funktion, som har formen:
Funktionen er ret kompliceret, den behøver du ikke huske. Men vi kan se, at vi kan parametrisere normalfordelingen ved hjælp af gennemsnittet og spredningen/variansen. For forskellige værdier af gennemsnittet og spredningen kan vi så få forskellige grafer:
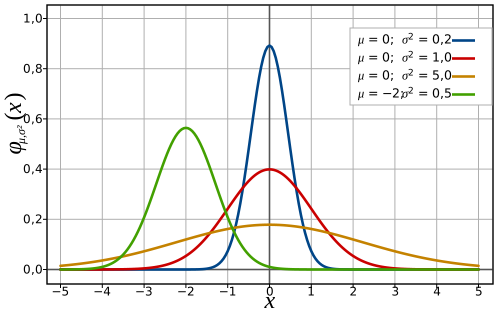
Normalfordelingen er vigtig, fordi den ret troværdigt efterligner forskellige fordelinger, som vi kan møde i virkeligheden. Vi kan se, at kurven altid har ét globalt maksimum, og det netop i punktet med gennemsnitsværdien. For eksempel har den røde kurve maksimum i punktet X = 0, så gennemsnitsværdien af denne størrelse er nul. Kurven er symmetrisk, den er symmetrisk om den linje, som står vinkelret på X-aksen og går gennem gennemsnittet, altså punktet X = 0. Med andre ord — kurven ser til venstre for nul ud ligesom til højre for nul. Den grønne kurve har de samme egenskaber, bare ikke med nul, men med punktet X = −2.
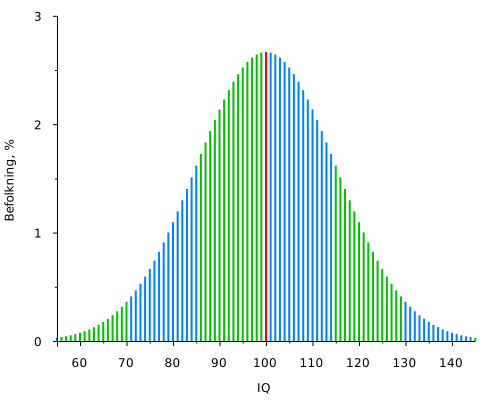
Normalfordelingen kan troværdigt beskrive fordelingen af intelligens eller IQ blandt mennesker. Gennemsnitsværdien af IQ er — pr. definition — 100. Samtidig gælder det, at der er cirka lige mange mennesker, som har en IQ højere end 100 og lavere end 100. Der er cirka lige så mange med en lidt under gennemsnitlig intelligens som med en lidt over gennemsnitlig, og der er lige så mange dumrianer som genier. Selv om det ind imellem ikke ser sådan ud :-). Grafen, der viser den omtrentlige fordeling af IQ:
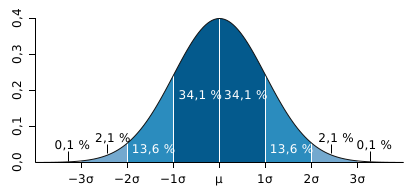
I normalfordelingen spiller spredningen en stor rolle. Hvis vi har en fordeling, som er normal og har spredningen σ, så gælder det, at cirka 68 % af værdierne ligger i intervallet [μ − σ; μ + σ]. Altså afviger cirka 68 % af værdierne højst én spredning fra gennemsnittet. Cirka 95 % af værdierne ligger så i intervallet [μ − 2σ; μ + 2σ] og 99,7 % af værdierne i intervallet [μ − 3σ; μ + 3σ]. Det viser følgende figur overskueligt:
Henvisninger og kilder
- Nogle af figurerne er fra Wikipedia, artiklerne Normalfordeling og Intelligence.
