
Sannolikhetsfördelning
Sannolikhetsfördelningen för en slumpvariabel anger hur stor sannolikheten är att slumpvariabeln får just ett visst värde.
Fördelning för en diskret variabel
Låt oss ta en diskret slumpvariabel. Vi skulle till exempel kunna följa hur många stora starka stammisen Kalle dricker per dag. Genom att följa Kalle under en hel månad har vi gjort följande tabell:
| Dag | Antal stora starka | Dag | Antal stora starka | Dag | Antal stora starka |
|---|---|---|---|---|---|
| 1 | 5 | 11 | 10 | 21 | 4 |
| 2 | 10 | 12 | 5 | 22 | 6 |
| 3 | 4 | 13 | 12 | 23 | 10 |
| 4 | 4 | 14 | 10 | 24 | 10 |
| 5 | 5 | 15 | 12 | 25 | 4 |
| 6 | 4 | 16 | 12 | 26 | 5 |
| 7 | 0 | 17 | 6 | 27 | 10 |
| 8 | 5 | 18 | 10 | 28 | 5 |
| 9 | 4 | 19 | 6 | 29 | 0 |
| 10 | 5 | 20 | 10 | 30 | 10 |
Vi ser att Kalle höll igen lite i början av månaden, men sedan hällde han i sig det ena ölet efter det andra. Och veckan från den elfte dagen måste ha varit vild. Låt oss beteckna den här diskreta slumpvariabeln X. Nu vill vi veta vad sannolikheten är att Kalle en viss dag i månaden dricker precis x stora starka.
Innan vi räknar ut själva sannolikheten ritar vi ett vanligt frekvensdiagram. Vi tar fram alla antal stora starka som Kalle någon dag drack och för in dem i frekvensdiagrammet. Till exempel drack Kalle tio stora starka sammanlagt nio gånger, så för värdet tio får vi en stapel med värdet nio:
Diagrammet läser vi så att Kalle drack sex stora starka tre dagar i månaden.
Hur stor är sannolikheten att Kalle drack tio stora starka en dag? Formellt skulle vi skriva det så här: sannolikhetsfunktionen betecknar vi P, och frågan om tio stora starka skulle vi skriva så här: P(X = 10). Därmed frågar vi hur stor sannolikheten är att slumpvariabeln X antar värdet tio.
Sannolikheten är lika med den relativa frekvensen för det givna värdet. Därför ritar vi också ett diagram över relativa frekvenser:
Nu kan vi säga att P(X = 10) är lika med 0,3, alltså 30 %.
Statistisk och matematisk sannolikhet
Låt oss ta en vanlig tärning som exempel. Låt oss kasta den 600 gånger. Ur den klassiska matematiska sannolikhetens synvinkel har vi lika stor chans att få en etta, en tvåa, …, en sexa. Varje sida på tärningen har sannolikheten
Det kommer förstås med största sannolikhet inte att hända. I vårt experiment kan vi få de här resultaten:
| Siffra på tärningen | Antal kast | Relativ frekvens |
|---|---|---|
| 1 | 105 | 0,175 |
| 2 | 103 | 0,171666 |
| 3 | 90 | 0,15 |
| 4 | 96 | 0,16 |
| 5 | 100 | 0,16666 |
| 6 | 106 | 0,17666 |
Vi ser att den relativa frekvensen, och därmed sannolikheten, för en prick på tärningen är 0,175, alltså 17,5 %. Det ligger visserligen nära sannolikheten
Det betyder inte att den ena eller andra sannolikheten skulle vara fel. Att tillverka en helt perfekt balanserad tärning är inte alls lätt, och det kan också vara svårt att genomföra själva testet där vi kastar tärningen 600 gånger.
Den matematiska sannolikheten fungerar alltså under ideala förhållanden, där vi skulle kasta tärningen i all oändlighet. Ju längre vi kastade en idealiskt balanserad tärning, desto närmare skulle de relativa frekvenserna för de enskilda kasten komma den teoretiska matematiska sannolikheten.
Därför skiljer vi mellan två sannolikheter — den matematiska, som utgår från idealiserade förhållanden, och den statistiska (också kallad empirisk), som vi beräknar från relativa frekvenser i våra data.
För att kunna beräkna den statistiska sannolikheten bör vi ha ett tillräckligt stort datamaterial. Till exempel har vi följt vår stammis Kalle bara under en månad, men det vore mycket bättre om vi följde honom i minst ett år.
Fördelning för en kontinuerlig variabel
För en kontinuerlig variabel bestämmer vi inte sannolikheten i en enskild punkt utan alltid bara i ett intervall. Sannolikheten är lika med storleken på arean under kurvan, så för beräkningen behöver vi en integral. Vi kan ha ett sådant diagram för en kontinuerlig variabel, det kan till exempel gälla mätning av någon avvikelse i cm:
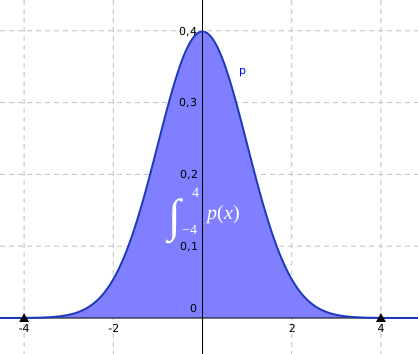
På x-axeln har vi alltså värden i cm och på y-axeln relativa frekvenser. Säg att vi bara har uppmätt värden i intervallet [−4, 4]. Den empiriska sannolikheten att vi mäter en avvikelse i det här intervallet är då 1, dvs. 100 %.
Hur hänger det ihop med arean? Vi säger att storleken på arean
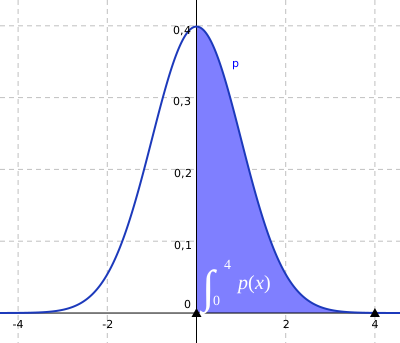
Den föregående markerade delen motsvarade 100 %, den här motsvarar 50 %, eftersom arean uppenbarligen är hälften så stor. Exakt skulle vi uttrycka den statistiska sannolikheten som kvoten
Stora talens lag
Det föregående avsnittet hänger ihop med den välkända stora talens lag. Den säger informellt att den relativa frekvensen (den statistiska sannolikheten) närmar sig den matematiska sannolikheten när antalet oberoende försök är stort.
Vi kan återigen föreställa oss det med ett myntkast. Vi kan få krona eller klave, och varje sida har sannolikheten
Om vi kastar sammanlagt tio gånger kan vi få krona sju gånger och klave tre gånger. Det ger frekvenserna
Så kan vi fortsätta. Om vi kastade myntet tusen gånger skulle vi kunna få krona 520 gånger och klave 480 gånger. Det ger frekvenserna
Lägg märke till att trots att de relativa frekvenserna ligger mycket närmare en halv är de absoluta frekvenserna mycket längre från den ”ideala” frekvensen. När vi kastade myntet tio gånger var den ideala absoluta frekvensen för varje sida 5. Alltså att vi får krona fem gånger och klave fem gånger. Eftersom vi fick krona sju gånger blir skillnaden två kast: 7 − 5 = 2. Vi kastade ”två kast fel” jämfört med vad som skulle ha hänt i den ideala situationen.
När vi däremot kastade myntet tusen gånger fick vi krona 520 gånger, vilket ger en skillnad på 20 kast från idealet, eftersom varje sida i det ideala fallet skulle ha kommit upp 500 gånger. Det verkar alltså som att ju fler gånger vi kastar, desto längre bort hamnar resultaten.
Det gör ingenting. Stora talens lag påstår inte att de absoluta frekvenserna närmar sig idealet, utan de relativa. Och de närmar sig. I absoluta frekvenser kommer resultaten alltså kanske att avlägsna sig, men i relativa kommer de att närma sig.
