Kansverdeling
De verdeling of kansverdeling van een toevalsvariabele vertelt ons hoe groot de kans is dat de toevalsvariabele precies een bepaalde waarde heeft.
Verdeling van een discrete variabele
Neem een discrete toevalsvariabele: we zouden bijvoorbeeld kunnen bijhouden hoeveel glazen bier de plaatselijke stamgast Sjaak per dag drinkt. Door Sjaak een hele maand te volgen hebben we de volgende tabel gemaakt:
| Dag | Glazen bier | Dag | Glazen bier | Dag | Glazen bier |
|---|---|---|---|---|---|
| 1 | 5 | 11 | 10 | 21 | 4 |
| 2 | 10 | 12 | 5 | 22 | 6 |
| 3 | 4 | 13 | 12 | 23 | 10 |
| 4 | 4 | 14 | 10 | 24 | 10 |
| 5 | 5 | 15 | 12 | 25 | 4 |
| 6 | 4 | 16 | 12 | 26 | 5 |
| 7 | 0 | 17 | 6 | 27 | 10 |
| 8 | 5 | 18 | 10 | 28 | 5 |
| 9 | 4 | 19 | 6 | 29 | 0 |
| 10 | 5 | 20 | 10 | 30 | 10 |
We zien dat Sjaak zich aan het begin van de maand nog een beetje inhield, maar daarna het ene biertje na het andere achterover sloeg. En die week vanaf de 11e dag moet gek zijn geweest. We noemen deze discrete toevalsvariabele X. Nu willen we weten hoe groot de kans is dat Sjaak op een willekeurige dag van de maand precies x glazen bier drinkt.
Voordat we de kans zelf uitrekenen, maken we een gewoon frequentiediagram. We zoeken alle aantallen glazen bier op die Sjaak op een of andere dag dronk en zetten die in een frequentiediagram. Tien glazen dronk Sjaak bijvoorbeeld in totaal negen keer, dus bij de waarde tien glazen krijgen we een staaf met de waarde negen:
We lezen de grafiek zo: Sjaak dronk drie dagen in de maand zes glazen.
Hoe groot is de kans dat Sjaak op een dag tien glazen dronk? Formeel schrijven we dat zo op: de kansfunctie noemen we P en de vraag naar tien glazen schrijven we zo: P(X = 10). Daarmee vragen we: hoe groot is de kans dat de toevalsvariabele X de waarde tien aanneemt?
De kans zal gelijk zijn aan de relatieve frequentie van de gegeven waarde. We maken dus ook nog een diagram van de relatieve frequentie:
Nu kunnen we zeggen dat P(X = 10) gelijk is aan 0,3, dus 30%.
Statistische versus wiskundige kans
Neem als voorbeeld een gewone dobbelsteen. Laten we er 600 keer mee gooien. Vanuit het oogpunt van de klassieke wiskundige kans hebben we evenveel kans dat er een 1, een 2, …, een 6 valt. Elk vlak van de dobbelsteen heeft kans
Zo precies zal het natuurlijk vrijwel nooit uitkomen. In ons experiment kunnen we deze resultaten krijgen:
| Getal op de dobbelsteen | Aantal worpen | Relatieve frequentie |
|---|---|---|
| 1 | 105 | 0,175 |
| 2 | 103 | 0,171666 |
| 3 | 90 | 0,15 |
| 4 | 96 | 0,16 |
| 5 | 100 | 0,16666 |
| 6 | 106 | 0,17666 |
We zien dat de relatieve frequentie van één oog, en dus ook de kans daarop, 0,175 is, dat is 17,5%. Dat ligt wel dicht bij de kans
Dat betekent niet dat de ene of de andere kans fout zou zijn. Een volkomen evenwichtige dobbelsteen maken is helemaal geen makkelijke opgave, en ook het uitvoeren van de test zelf, waarbij we 600 keer met de dobbelsteen gooien, kan lastig zijn.
De wiskundige kans werkt dus onder ideale omstandigheden, waarin we oneindig lang met de dobbelsteen zouden gooien. Hoe langer we met een ideaal evenwichtige dobbelsteen zouden gooien, hoe meer de relatieve frequenties van de afzonderlijke worpen de theoretische wiskundige kans zouden benaderen.
Daarom maken we onderscheid tussen twee kansen — de wiskundige, die uitgaat van geïdealiseerde omstandigheden, en de statistische (ook wel empirische) kans, die we berekenen uit de relatieve frequenties van onze gegevens.
Om de statistische kans te kunnen berekenen, moeten we een voldoende grote gegevensverzameling hebben. Onze stamgast Sjaak hebben we bijvoorbeeld maar één maand gevolgd, maar het zou veel beter zijn als we hem minstens een jaar zouden volgen.
Verdeling van een continue variabele
Bij een continue variabele bepalen we de kans niet in een bepaald punt, maar altijd alleen in een interval. De kans is gelijk aan de grootte van de oppervlakte onder de kromme, dus voor de berekening hebben we een integraal nodig. We kunnen zo'n grafiek van een continue variabele hebben, het kan bijvoorbeeld gaan om de meting van een afwijking in cm:
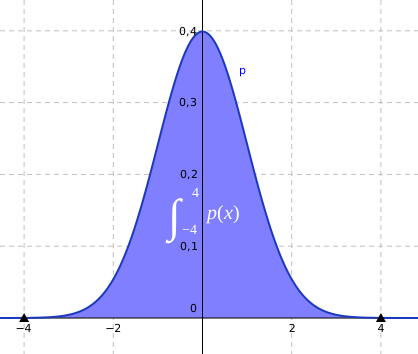
Op de x-as staan dus waarden in cm, op de y-as staan relatieve frequenties. Stel dat we alleen waarden hebben gemeten in het interval [−4, 4]. De empirische kans dat we een afwijking in dit interval meten, is dan 1, dus 100%.
Hoe hangt de oppervlakte daarmee samen? We zeggen dat de grootte van de oppervlakte
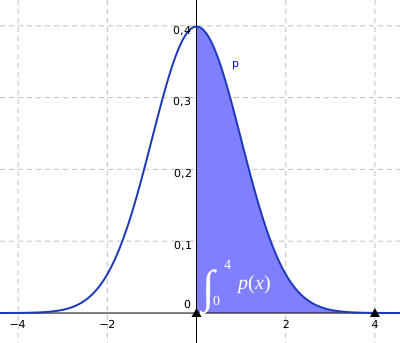
Het eerder gekleurde deel kwam overeen met 100%, dit deel komt overeen met 50%, omdat de oppervlakte duidelijk de helft is. Precies zouden we de statistische kans uitdrukken als de verhouding
De wet van de grote aantallen
Met het vorige hoofdstuk hangt de bekende wet van de grote aantallen samen. Die zegt, informeel gezegd, dat bij een groot aantal onafhankelijke experimenten de relatieve frequentie (statistische kans) de wiskundige kans zal benaderen.
We kunnen het ons weer voorstellen bij het opgooien van een munt. Er kan kop of munt vallen, elke kant heeft kans
Als we in totaal tien keer gooien, kan er zeven keer kop en drie keer munt vallen. Dat zijn de frequenties
Zo kunnen we doorgaan. Als we duizend keer met de munt zouden gooien, zou er 520 keer kop en 480 keer munt kunnen vallen. Dat zijn de frequenties
Merk op dat de relatieve frequenties weliswaar veel dichter bij een half liggen, maar dat de absolute frequenties veel verder van de “ideale” frequentie af liggen. Toen we tien keer met de munt gooiden, was de ideale absolute frequentie bij elke kant 5. Dus dat er vijf keer kop en vijf keer munt valt. Omdat er zeven keer kop viel, geeft dat een verschil van twee worpen: 7 − 5 = 2. We wijken “twee worpen” af van wat er in de ideale situatie zou gebeuren.
Toen we echter duizend keer met de munt gooiden, viel er 520 keer kop, wat een verschil van 20 worpen met het ideaal geeft, want in het ideale geval zou elke kant 500 keer moeten vallen. Het lijkt dus alsof we, hoe vaker we gooien, resultaten krijgen die steeds verder van het ideaal liggen.
Dat maakt echter niet uit, de wet van de grote aantallen beweert niet dat de absolute frequenties het ideaal gaan benaderen, maar de relatieve. En die benaderen het wel. In absolute frequenties zullen we dus misschien verder weggaan, maar in relatieve komen we steeds dichterbij.
