Valószínűség-eloszlás
Egy valószínűségi változó valószínűség-eloszlása megmondja, mekkora a valószínűsége annak, hogy a változó éppen egy adott értéket vesz fel.
Diszkrét változó eloszlása
Legyen adott egy diszkrét valószínűségi változó. Figyelhetjük például, hány korsó sört iszik meg naponta Béla bácsi, a helyi törzsvendég. Egy egész hónapon át figyelve őt, a következő táblázatot készítettük el:
| Nap | Korsó sör | Nap | Korsó sör | Nap | Korsó sör |
|---|---|---|---|---|---|
| 1. | 5 | 11. | 10 | 21. | 4 |
| 2. | 10 | 12. | 5 | 22. | 6 |
| 3. | 4 | 13. | 12 | 23. | 10 |
| 4. | 4 | 14. | 10 | 24. | 10 |
| 5. | 5 | 15. | 12 | 25. | 4 |
| 6. | 4 | 16. | 12 | 26. | 5 |
| 7. | 0 | 17. | 6 | 27. | 10 |
| 8. | 5 | 18. | 10 | 28. | 5 |
| 9. | 4 | 19. | 6 | 29. | 0 |
| 10. | 5 | 20. | 10 | 30. | 10 |
Látjuk, hogy Béla bácsi a hónap elején még egy kicsit visszafogta magát, de aztán sorra hajtotta fel a söröket. És a 11. naptól kezdődő hétnek őrületesnek kellett lennie. Jelöljük ezt a diszkrét valószínűségi változót X-szel. Most az érdekel minket, mekkora a valószínűsége annak, hogy Béla bácsi a hónap egy adott napján éppen x korsó sört iszik meg.
Mielőtt kiszámolnánk magát a valószínűséget, megszerkesztjük a szokásos gyakorisági grafikont. Összeszedjük az összes korsó sört, amennyit Béla bácsi valamelyik nap megivott, és felvisszük őket a gyakorisági grafikonra. Például tíz korsót Béla bácsi összesen kilenc napon ivott meg, tehát a tíz korsóhoz egy olyan oszlop tartozik, amelynek az értéke kilenc:
A grafikont úgy olvassuk, hogy Béla bácsi a hónap három napján ivott hat korsót.
Mekkora a valószínűsége annak, hogy Béla bácsi egy nap tíz korsó sört ivott? Formálisan így írnánk fel: a valószínűségi függvényt jelöljük P-vel, és a tíz korsóra vonatkozó kérdést így írnánk: P(X = 10). Ezzel azt kérdezzük, mekkora a valószínűsége annak, hogy az X valószínűségi változó értéke tíz.
A valószínűség az adott érték relatív gyakoriságával lesz egyenlő. Szerkesszük meg tehát még a relatív gyakoriság grafikonját is:
Most már mondhatjuk, hogy P(X = 10) egyenlő 0,3-mal, azaz 30%-kal.
Statisztikai és matematikai valószínűség
Vegyünk példának egy szabályos dobókockát. Próbáljuk meg 600-szor feldobni. A klasszikus matematikai valószínűség szempontjából egyforma esélyünk van arra, hogy egyest, kettest, …, hatost dobunk. A kocka minden lapjának a dobási valószínűsége
Ez természetesen valószínűleg nem fog bekövetkezni. A kísérletünkben például ezeket az eredményeket kaphatjuk:
| A kockán lévő szám | Dobások száma | Relatív gyakoriság |
|---|---|---|
| 1 | 105 | 0,175 |
| 2 | 103 | 0,171666 |
| 3 | 90 | 0,15 |
| 4 | 96 | 0,16 |
| 5 | 100 | 0,16666 |
| 6 | 106 | 0,17666 |
Látjuk, hogy az egy pont előfordulásának relatív gyakorisága, és így valószínűsége is a kockán 0,175, ami 17,5%. Ez ugyan közel van a
Ez nem jelenti azt, hogy az egyik vagy a másik valószínűség rossz lenne. Egy tökéletesen kiegyensúlyozott kockát elkészíteni egyáltalán nem könnyű feladat, és magát a tesztet, amikor a kockával 600-szor dobunk, szintén nehéz lehet kivitelezni.
A matematikai valószínűség tehát ideális körülmények között működik, amikor a kockával a végtelenségig dobnánk. Minél tovább dobnánk egy ideálisan kiegyensúlyozott kockával, annál inkább közelítenének az egyes dobások relatív gyakoriságai az elméleti matematikai valószínűséghez.
Ezért különböztetünk meg két valószínűséget – a matematikait, amely idealizált körülményekből indul ki, és a statisztikait (más néven empirikusat), amelyet az adataink relatív gyakoriságaiból számolunk ki.
A statisztikai valószínűség kiszámításához elég nagy adathalmazra van szükségünk. Például Béla bácsit csak egy hónapig figyeltük, sokkal jobb lenne, ha legalább egy évig figyelnénk.
Folytonos változó eloszlása
Folytonos változónál nem egy adott pontban határozzuk meg a valószínűséget, hanem mindig csak egy intervallumon. A valószínűség a görbe alatti terület nagyságával lesz egyenlő, ezért a számításhoz integrálra lesz szükségünk. Lehet ilyen grafikonunk egy folytonos változóról, például valamilyen eltérés mérése cm-ben:
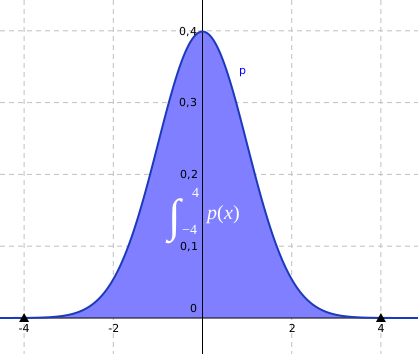
Az x tengelyen tehát cm-ben vannak az értékek, az y tengelyen a relatív gyakoriságok. Tegyük fel, hogy csak a [−4; 4] intervallumba eső értékeket mértük. Annak az empirikus valószínűsége, hogy ebben az intervallumban mérünk eltérést, tehát 1, azaz 100%.
Hogyan függ ez össze a területtel? Azt mondjuk, hogy az
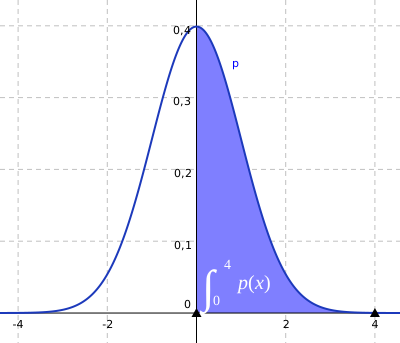
Az előző kiemelt rész 100%-nak felelt meg, ez 50%-nak, mert a terület nyilvánvalóan feleakkora. A statisztikai valószínűséget pontosan így fejeznénk ki, mint arányt:
A nagy számok törvénye
Az előző fejezethez kapcsolódik a híres nagy számok törvénye. Ez informálisan azt mondja, hogy független kísérletek nagy száma esetén a relatív gyakoriság (a statisztikai valószínűség) közelíteni fog a matematikai valószínűséghez.
Képzeljük el ezt újra a pénzfeldobás példáján. Fej vagy írás eshet, mindkét oldal valószínűsége
Ha összesen tízszer dobunk, hétszer eshet fej és háromszor írás. Ezek a gyakoriságok
Így folytathatnánk tovább. Ha ezerszer dobnánk fel a pénzt, eshetne 520-szor fej és 480-szor írás. Ezek már a
Vedd észre, hogy bár a relatív gyakoriságok sokkal közelebb vannak az egy kettedhez, az abszolút gyakoriságok az „ideális” gyakoriságtól sokkal messzebb vannak. Amikor tízszer dobtuk fel a pénzt, az ideális abszolút gyakoriság mindkét oldalnál 5 volt. Vagyis ötször esik fej és ötször írás. Mivel a fej hétszer esett, ez két dobás különbséget jelent: 7 − 5 = 2. „Két dobással másképp” dobtunk, mint ami az ideális helyzetben történne.
Amikor viszont ezerszer dobtuk fel a pénzt, a fej 520-szor esett, ami 20 dobás eltérés az ideálistól, mert ideális esetben mindkét oldalnak 500-szor kellett volna esnie. Úgy tűnhet tehát, hogy minél többször dobunk, annál távolabbi eredményeket kapunk.
Ez azonban egyáltalán nem baj, a nagy számok törvénye nem azt állítja, hogy az abszolút gyakoriságok közelítenek az ideálishoz, hanem a relatívak. És azok közelítenek. Tehát az abszolút gyakoriságokban talán távolodni fogunk, de a relatívakban közeledni.
