Sannsynlighetsfordeling
Sannsynlighetsfordelingen til en stokastisk variabel forteller oss hvor stor sannsynligheten er for at den stokastiske variabelen får akkurat en bestemt verdi.
Fordeling av en diskret variabel
La oss ha en diskret stokastisk variabel. Vi kunne for eksempel følge med på hvor mange halvlitere øl den lokale ølsluken Bamsen drikker per dag. Ved å følge Bamsen en hel måned laget vi følgende tabell:
| Dag | Halvlitere øl | Dag | Halvlitere øl | Dag | Halvlitere øl |
|---|---|---|---|---|---|
| 1. | 5 | 11. | 10 | 21. | 4 |
| 2. | 10 | 12. | 5 | 22. | 6 |
| 3. | 4 | 13. | 12 | 23. | 10 |
| 4. | 4 | 14. | 10 | 24. | 10 |
| 5. | 5 | 15. | 12 | 25. | 4 |
| 6. | 4 | 16. | 12 | 26. | 5 |
| 7. | 0 | 17. | 6 | 27. | 10 |
| 8. | 5 | 18. | 10 | 28. | 5 |
| 9. | 4 | 19. | 6 | 29. | 0 |
| 10. | 5 | 20. | 10 | 30. | 10 |
Vi ser at Bamsen holdt seg litt igjen i begynnelsen av måneden, men så tok han den ene ølen etter den andre. Og uken fra den 11. dagen må ha vært vill. Denne diskrete stokastiske variabelen betegner vi X. Nå er vi interessert i sannsynligheten for at Bamsen på en bestemt dag i måneden drikker akkurat x halvlitere øl.
Før vi regner ut selve sannsynligheten, lager vi et vanlig frekvensdiagram. Vi finner alle antallene halvlitere øl som Bamsen drakk en eller annen dag, og fører dem inn i frekvensdiagrammet. Ti halvlitere drakk Bamsen for eksempel ni ganger til sammen, så for verdien ti halvlitere får vi en søyle med verdien ni:
Diagrammet leser vi slik at Bamsen drakk seks halvlitere tre dager i måneden.
Hvor stor er sannsynligheten for at Bamsen drakk ti halvlitere på en dag? Formelt skriver vi det slik: sannsynlighetsfunksjonen betegner vi P, og spørsmålet om ti halvlitere skriver vi slik: P(X = 10). Dermed spør vi hvor stor sannsynligheten er for at den stokastiske variabelen X antar verdien ti.
Sannsynligheten er lik den relative frekvensen til den gitte verdien. Så vi lager også et diagram over relativ frekvens:
Nå kan vi si at P(X = 10) er lik 0,3, altså 30 %.
Statistisk og matematisk sannsynlighet
La oss ta en vanlig terning som eksempel. Vi prøver å kaste den 600 ganger. Ut fra klassisk matematisk sannsynlighet har vi like stor sjanse for å få en ener, en toer, …, en sekser. Hver side på terningen har sannsynligheten
Det skjer selvfølgelig neppe. I forsøket vårt kan vi få disse resultatene:
| Tall på terningen | Antall kast | Relativ frekvens |
|---|---|---|
| 1 | 105 | 0,175 |
| 2 | 103 | 0,171666 |
| 3 | 90 | 0,15 |
| 4 | 96 | 0,16 |
| 5 | 100 | 0,16666 |
| 6 | 106 | 0,17666 |
Vi ser at den relative frekvensen, og dermed også sannsynligheten, for ett øye på terningen er 0,175, som er 17,5 %. Det er riktignok nær sannsynligheten
Det betyr ikke at den ene eller den andre sannsynligheten er feil. Det er slett ikke lett å lage en helt perfekt balansert terning, og det kan også være vanskelig å gjennomføre selve testen der vi kaster terningen 600 ganger.
Matematisk sannsynlighet fungerer altså under ideelle forhold, der vi kunne kastet terningen uendelig mange ganger. Jo lenger vi kastet en ideelt balansert terning, desto nærmere ville de relative frekvensene til de enkelte kastene kommet den teoretiske matematiske sannsynligheten.
Derfor skiller vi mellom to sannsynligheter: den matematiske, som bygger på idealiserte forhold, og den statistiske (også kalt empirisk), som vi regner ut fra relative frekvenser i dataene våre.
For å kunne regne ut den statistiske sannsynligheten bør vi ha et stort nok datasett. Fyllikken Bamsen fulgte vi for eksempel bare i én måned, men det ville vært mye bedre om vi hadde fulgt ham i minst ett år.
Fordeling av en kontinuerlig variabel
For en kontinuerlig variabel bestemmer vi ikke sannsynligheten i et bestemt punkt, men alltid bare i et intervall. Sannsynligheten blir lik størrelsen på arealet under kurven, så for å regne den ut trenger vi integralet. Vi kan ha en slik graf for en kontinuerlig variabel, det kan for eksempel dreie seg om måling av et avvik i cm:
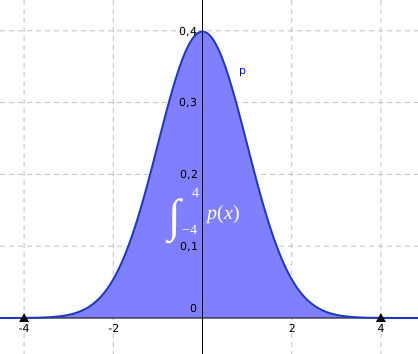
På x-aksen har vi altså verdier i cm, og på y-aksen har vi relative frekvenser. La oss si at vi bare har målt verdier i intervallet [−4, 4]. Den empiriske sannsynligheten for at vi måler et avvik i dette intervallet er da 1, altså 100 %.
Hvordan henger dette sammen med arealet? Vi sier at størrelsen på arealet
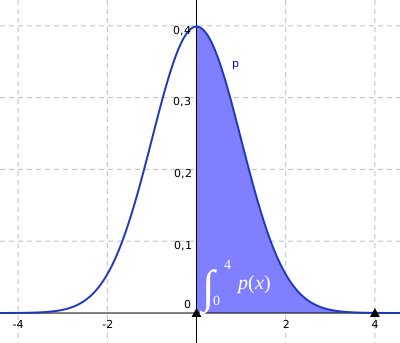
Det forrige uthevede området tilsvarte 100 %, dette tilsvarer 50 %, fordi arealet åpenbart er halvparten så stort. Mer nøyaktig kan vi uttrykke den statistiske sannsynligheten som forholdet
De store talls lov
Den kjente loven om store tall henger sammen med det forrige avsnittet. Den sier uformelt at ved et stort antall uavhengige forsøk vil den relative frekvensen (den statistiske sannsynligheten) nærme seg den matematiske sannsynligheten.
Vi kan tenke på det igjen med myntkast. Vi kan få mynt eller krone, og hver side har sannsynligheten
Hvis vi kaster ti ganger til sammen, kan vi få mynt sju ganger og krone tre ganger. Det er frekvensene
Slik kunne vi fortsette. Hvis vi kastet mynten tusen ganger, kunne vi få mynt 520 ganger og krone 480 ganger. Det er frekvensene
Legg merke til at selv om de relative frekvensene ligger mye nærmere én halv, er de absolutte frekvensene mye lenger unna den «ideelle» frekvensen. Da vi kastet mynten ti ganger, var den ideelle absolutte frekvensen 5 for hver side. Det vil si at vi får mynt fem ganger og krone fem ganger. Fordi vi fikk mynt sju ganger, gir det en differanse på to kast: 7 − 5 = 2. Vi kastet «to kast annerledes» enn i den ideelle situasjonen.
Men da vi kastet mynten tusen ganger, kom mynt opp 520 ganger, og det gir en differanse på 20 kast fra idealet, fordi hver side i det ideelle tilfellet skulle ha kommet opp 500 ganger. Det kunne altså se ut til at jo flere ganger vi kaster, desto mer avvikende resultater får vi.
Det gjør ikke noe, for loven om store tall sier ikke at vi nærmer oss idealet for de absolutte frekvensene, men for de relative. Og de nærmer seg. I absolutte frekvenser vil vi altså kanskje fjerne oss, men i relative nærmer vi oss.
