Wahrscheinlichkeitsverteilung
Die Wahrscheinlichkeitsverteilung einer Zufallsgröße gibt uns an, mit welcher Wahrscheinlichkeit die Zufallsgröße genau einen bestimmten Wert annimmt.
Verteilung einer diskreten Zufallsgröße
Nehmen wir eine diskrete Zufallsgröße, zum Beispiel könnten wir beobachten, wie viele Halbe Bier der örtliche Trunkenbold Sepp pro Tag trinkt. Indem wir Sepp einen ganzen Monat lang beobachtet haben, haben wir die folgende Tabelle erstellt:
| Tag | Halbe Bier | Tag | Halbe Bier | Tag | Halbe Bier |
|---|---|---|---|---|---|
| 1. | 5 | 11. | 10 | 21. | 4 |
| 2. | 10 | 12. | 5 | 22. | 6 |
| 3. | 4 | 13. | 12 | 23. | 10 |
| 4. | 4 | 14. | 10 | 24. | 10 |
| 5. | 5 | 15. | 12 | 25. | 4 |
| 6. | 4 | 16. | 12 | 26. | 5 |
| 7. | 0 | 17. | 6 | 27. | 10 |
| 8. | 5 | 18. | 10 | 28. | 5 |
| 9. | 4 | 19. | 6 | 29. | 0 |
| 10. | 5 | 20. | 10 | 30. | 10 |
Wir sehen, dass sich Sepp zu Monatsbeginn noch ein wenig zurückgehalten hat, aber dann hat er ein Bier nach dem anderen hinuntergekippt. Und die Woche ab dem 11. Tag muss wild gewesen sein. Bezeichnen wir diese diskrete Zufallsgröße mit X. Jetzt interessiert uns, wie groß die Wahrscheinlichkeit ist, dass Sepp an einem Tag des Monats genau x Halbe Bier trinkt.
Bevor wir die Wahrscheinlichkeit selbst berechnen, erstellen wir ein gewöhnliches Häufigkeitsdiagramm. Wir suchen alle Mengen an Halben heraus, die Sepp an irgendeinem Tag getrunken hat, und tragen sie in das Häufigkeitsdiagramm ein. Zum Beispiel hat Sepp insgesamt neunmal zehn Halbe getrunken, also haben wir für den Wert zehn Halbe eine Säule mit dem Wert neun:
Das Diagramm lesen wir so, dass Sepp an drei Tagen im Monat sechs Halbe getrunken hat.
Wie groß ist die Wahrscheinlichkeit, dass Sepp an einem Tag zehn Halbe getrunken hat? Formal würden wir das so schreiben: Die Wahrscheinlichkeitsfunktion bezeichnen wir mit P, und die Frage nach den zehn Halben würden wir so schreiben: P(X = 10). Damit fragen wir, wie groß die Wahrscheinlichkeit ist, dass die Zufallsgröße X den Wert zehn annimmt.
Die Wahrscheinlichkeit ist gleich der relativen Häufigkeit des jeweiligen Wertes. Also erstellen wir noch ein Diagramm der relativen Häufigkeit:
Jetzt können wir sagen, dass P(X = 10) gleich 0,3 ist, also 30 %.
Statistische vs. mathematische Wahrscheinlichkeit
Nehmen wir als Beispiel einen klassischen Spielwürfel. Versuchen wir, damit 600-mal zu würfeln. Aus Sicht der klassischen mathematischen Wahrscheinlichkeit haben wir die gleiche Chance, dass die Eins, die Zwei, …, die Sechs fällt. Jede Seite des Würfels hat die Wahrscheinlichkeit
Das passiert natürlich höchstwahrscheinlich nicht. In unserem Experiment können wir diese Ergebnisse erhalten:
| Zahl auf dem Würfel | Anzahl der Würfe | Relative Häufigkeit |
|---|---|---|
| 1 | 105 | 0,175 |
| 2 | 103 | 0,171666 |
| 3 | 90 | 0,15 |
| 4 | 96 | 0,16 |
| 5 | 100 | 0,16666 |
| 6 | 106 | 0,17666 |
Wir sehen, dass die relative Häufigkeit und damit auch die Wahrscheinlichkeit, eine Eins zu würfeln, 0,175 beträgt, also 17,5 %. Das ist zwar nahe an der Wahrscheinlichkeit
Das bedeutet nicht, dass die eine oder die andere Wahrscheinlichkeit falsch wäre. Einen vollkommen ausgewogenen Würfel zu bauen ist gar keine leichte Aufgabe, ebenso kann es schwierig sein, den Test selbst durchzuführen, bei dem wir 600-mal würfeln.
Die mathematische Wahrscheinlichkeit funktioniert also unter idealen Bedingungen, bei denen wir unendlich oft würfeln würden. Je länger wir mit einem ideal ausgewogenen Würfel würfeln würden, desto mehr würden sich die relativen Häufigkeiten der einzelnen Würfe der theoretischen mathematischen Wahrscheinlichkeit annähern.
Deshalb unterscheiden wir zwei Wahrscheinlichkeiten – die mathematische, die von idealisierten Bedingungen ausgeht, und die statistische (auch empirische), die wir aus den relativen Häufigkeiten unserer Daten berechnen.
Um die statistische Wahrscheinlichkeit zu berechnen, sollten wir einen ausreichend großen Datensatz zur Verfügung haben. Unseren Trunkenbold Sepp haben wir zum Beispiel nur einen Monat lang beobachtet, viel besser wäre es aber, wenn wir ihn mindestens ein Jahr lang beobachten würden.
Verteilung einer stetigen Zufallsgröße
Bei einer stetigen Zufallsgröße bestimmen wir die Wahrscheinlichkeit nicht an einem bestimmten Punkt, sondern immer nur in einem Intervall. Die Wahrscheinlichkeit ist gleich der Größe der Fläche unter der Kurve, also brauchen wir für die Berechnung ein Integral. Wir können ein solches Diagramm einer stetigen Zufallsgröße haben, es kann sich zum Beispiel um die Messung einer Abweichung in cm handeln:
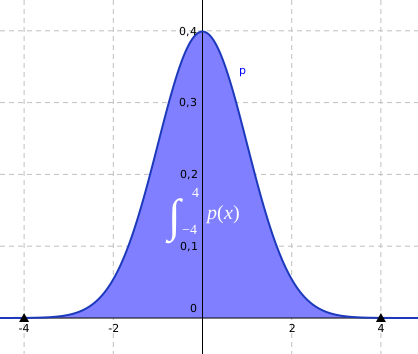
Auf der x-Achse haben wir also Werte in cm, auf der y-Achse haben wir relative Häufigkeiten. Nehmen wir an, wir haben nur Werte im Intervall [−4; 4] gemessen. Die empirische Wahrscheinlichkeit, dass wir eine Abweichung in diesem Intervall messen, ist dann 1, d. h. 100 %.
Wie hängt damit die Fläche zusammen? Wir sagen, dass die Größe der Fläche
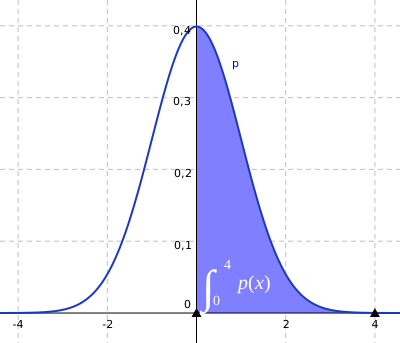
Der vorherige hervorgehobene Teil entsprach 100 %, dieser entspricht 50 %, weil der Flächeninhalt offensichtlich halb so groß ist. Genau würden wir die statistische Wahrscheinlichkeit als Verhältnis ausdrücken
Gesetz der großen Zahlen
Mit dem vorigen Kapitel hängt das bekannte Gesetz der großen Zahlen zusammen. Es besagt informell, dass sich bei einer großen Anzahl unabhängiger Versuche die relative Häufigkeit (statistische Wahrscheinlichkeit) der mathematischen Wahrscheinlichkeit annähert.
Wir können uns das wieder an einem Münzwurf vorstellen. Es kann Kopf oder Zahl fallen, jede Seite hat die Wahrscheinlichkeit
Wenn wir insgesamt zehnmal werfen, kann siebenmal Kopf und dreimal Zahl fallen. Das sind die Häufigkeiten
So könnten wir weitermachen. Wenn wir die Münze tausendmal werfen, könnte 520-mal Kopf und 480-mal Zahl fallen. Das sind schon die Häufigkeiten
Beachte, dass die relativen Häufigkeiten zwar viel näher an einhalb liegen, die absoluten Häufigkeiten aber vom „idealen“ Wert viel weiter entfernt sind. Als wir die Münze zehnmal geworfen haben, war die ideale absolute Häufigkeit bei jeder Seite 5. Also dass uns fünfmal Kopf und fünfmal Zahl fallen. Weil uns siebenmal Kopf gefallen ist, ergibt das einen Unterschied von zwei Würfen: 7 − 5 = 2. Wir haben „um zwei Würfe anders“ geworfen, als es in der idealen Situation der Fall wäre.
Als wir die Münze aber tausendmal geworfen haben, fiel 520-mal Kopf, was einen Unterschied von 20 Würfen zum Ideal ergibt, weil im Idealfall jede Seite 500-mal hätte fallen sollen. Es scheint also, dass wir umso weiter entfernte Ergebnisse erhalten, je öfter wir werfen.
Das macht aber nichts, das Gesetz der großen Zahlen behauptet nicht, dass sich die absoluten Häufigkeiten dem Ideal annähern, sondern die relativen. Und die nähern sich an. In den absoluten Häufigkeiten werden wir uns also vielleicht entfernen, in den relativen aber annähern.
