
확률분포
확률변수의 확률분포는 확률변수가 어떤 값을 가질 확률이 얼마인지 알려 준다.
이산변수의 분포
어떤 이산확률변수가 있다고 하자. 예를 들어 커피를 아주 좋아하는 민호가 하루에 커피를 몇 잔 마시는지 관찰할 수 있다. 민호를 한 달 동안 관찰해서 다음 표를 만들었다.
| 날짜 | 커피 잔 수 | 날짜 | 커피 잔 수 | 날짜 | 커피 잔 수 |
|---|---|---|---|---|---|
| 1일 | 5 | 11일 | 10 | 21일 | 4 |
| 2일 | 10 | 12일 | 5 | 22일 | 6 |
| 3일 | 4 | 13일 | 12 | 23일 | 10 |
| 4일 | 4 | 14일 | 10 | 24일 | 10 |
| 5일 | 5 | 15일 | 12 | 25일 | 4 |
| 6일 | 4 | 16일 | 12 | 26일 | 5 |
| 7일 | 0 | 17일 | 6 | 27일 | 10 |
| 8일 | 5 | 18일 | 10 | 28일 | 5 |
| 9일 | 4 | 19일 | 6 | 29일 | 0 |
| 10일 | 5 | 20일 | 10 | 30일 | 10 |
민호는 월초에는 아직 조금 아꼈지만, 그 뒤로는 한 잔 또 한 잔 마셨다. 그리고 11일부터의 한 주는 엄청났을 것이다. 이 이산확률변수를 X라고 하자. 이제 민호가 그달의 어느 하루에 커피를 x잔 마실 확률이 얼마인지 알아보려고 한다.
확률 자체를 구하기 전에 보통의 도수 그래프를 그린다. 민호가 하루에 마신 커피 잔 수를 모두 찾아 도수 그래프에 나타낸다. 예를 들어 민호가 커피를 열 잔 마신 날은 모두 9일이므로, 값 열 잔에는 높이가 9인 막대가 생긴다.
예를 들어 그래프에서 민호가 커피를 여섯 잔 마신 날은 그달에 사흘이라는 것을 읽을 수 있다.
민호가 하루에 커피를 열 잔 마실 확률은 얼마일까? 형식적으로는 이렇게 쓴다. 확률을 P로 나타내고, 열 잔에 대한 질문은 P(X = 10)으로 쓴다. 즉 확률변수 X가 값 10을 가질 확률이 얼마인지 묻는 것이다.
확률은 그 값의 상대도수와 같다. 그래서 상대도수 그래프도 그린다.
이제 P(X = 10)은 0.3, 즉 30%라고 말할 수 있다.
통계적 확률과 수학적 확률
보통의 주사위를 예로 들어 600번 던져 보자. 고전적인 수학적 확률의 관점에서는 1, 2, …, 6이 나올 가능성이 모두 같다. 주사위의 각 면이 나올 확률은
물론 실제로는 아마 그렇게 되지 않는다. 실험에서는 예를 들어 다음 결과를 얻을 수 있다.
| 주사위의 눈 | 나온 횟수 | 상대도수 |
|---|---|---|
| 1 | 105 | 0.175 |
| 2 | 103 | 0.171666 |
| 3 | 90 | 0.15 |
| 4 | 96 | 0.16 |
| 5 | 100 | 0.16666 |
| 6 | 106 | 0.17666 |
주사위에서 1이 나온 상대도수, 즉 확률은 0.175, 다시 말해 17.5%이다. 확률
어느 쪽 확률이 틀렸다는 뜻은 아니다. 완벽하게 균형 잡힌 주사위를 만드는 것은 결코 쉬운 일이 아니고, 주사위를 600번 던지는 실험 자체도 하기 어려울 수 있다.
따라서 수학적 확률은 주사위를 끝없이 던지는 이상적인 조건에서 성립한다. 이상적으로 균형 잡힌 주사위를 오래 던질수록 각 눈의 상대도수는 이론적인 수학적 확률에 가까워진다.
그래서 두 가지 확률을 구별한다. 이상적인 조건에서 나오는 수학적 확률과, 자료의 상대도수로 구하는 통계적(경험적) 확률이다.
통계적 확률을 구하려면 자료가 충분히 많아야 한다. 예를 들어 민호는 한 달만 관찰했지만, 적어도 1년은 관찰하는 편이 훨씬 좋다.
연속변수의 분포
연속변수에서는 한 점에서의 확률이 아니라 언제나 구간에서의 확률을 정한다. 확률은 곡선 아래의 넓이와 같으므로 계산하려면 적분이 필요하다. 연속변수의 그래프는 예를 들어 다음과 같다. 어떤 오차를 cm 단위로 잰 것일 수 있다.
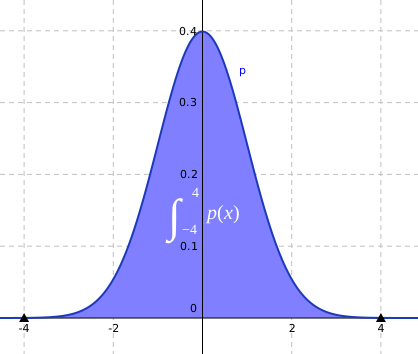
x축은 cm 단위의 값이고 y축은 상대도수이다. 측정한 값이 모두 구간 [−4, 4]에 있었다고 하자. 그러면 오차가 이 구간에 있을 경험적 확률은 1, 즉 100%이다.
넓이와는 어떤 관계가 있을까? 확률을 나타내는 함수를 p라고 할 때, 넓이
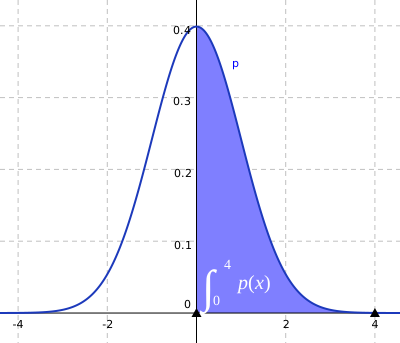
앞에서 색칠한 부분은 100%였고, 이 부분은 50%이다. 넓이가 분명히 절반이기 때문이다. 정확하게는 통계적 확률을 다음 비로 나타낸다.
큰수의 법칙
앞 절과 관련된 유명한 법칙이 큰수의 법칙이다. 이 법칙을 엄밀하지 않게 말하면, 독립적인 시행을 아주 많이 할수록 상대도수(통계적 확률)가 수학적 확률에 가까워진다는 것이다.
다시 동전 던지기로 생각해 보자. 앞면이나 뒷면이 나올 수 있고, 각 면의 확률은
모두 열 번 던지면 앞면이 일곱 번, 뒷면이 세 번 나올 수 있다. 상대도수는
이렇게 계속할 수 있다. 동전을 천 번 던지면 앞면이 520번, 뒷면이 480번 나올 수 있다. 상대도수는
상대도수는 2분의 1에 훨씬 가까워졌지만, 도수 자체는 “이상적인” 도수에서 훨씬 멀어졌다는 것에 주목하자. 동전을 열 번 던질 때 각 면의 이상적인 도수는 5였다. 즉 앞면이 다섯 번, 뒷면이 다섯 번 나오는 것이다. 앞면이 일곱 번 나왔으므로 차이는 7 − 5 = 2번이다. 이상적인 경우보다 “두 번 다르게” 나온 것이다.
하지만 동전을 천 번 던졌을 때는 앞면이 520번 나왔으므로, 이상적인 경우(각 면이 500번)와 20번 차이가 난다. 그래서 많이 던질수록 결과가 더 멀어지는 것처럼 보일 수 있다.
그래도 아무 문제가 없다. 큰수의 법칙은 도수가 아니라 상대도수가 이상에 가까워진다고 말한다. 그리고 상대도수는 가까워진다. 즉 도수로는 멀어질 수도 있지만 상대도수로는 가까워진다.